Claude Fable 5.2 er Anthropics beste AI-modell som er åpen for alle, lansert 9. november 2026. De fleste bedrifter trenger den bare til noen få, krevende tekniske oppgaver; resten går billigere på Claude Opus 5.5, som Anthropic anbefaler til daglig arbeid, eller på Sonnet 5.5 og Haiku 5.5 for enklere oppgaver.
Jeg har satt opp Fable 5.2 som rådgiver for de billigere modellene i Claude Code, og beskriver oppsettet lenger ned.
Hva er Claude Fable 5.2?
Claude Fable 5.2 er den nyeste toppmodellen i Claude-familien fra Anthropic. Den bygger på samme grunnmodell som Claude Mythos 5.2, men har strengere sperrer mot misbruk innen cybersikkerhet og biologi. Bakgrunnen for sperrene står i Fable 5 og sikkerhetssperrene for biologi. Mythos 5.2 er forbeholdt godkjente organisasjoner i Anthropics verifiseringsprogrammer, mens Fable 5.2 er åpen for alle.
Fable 5.2 finnes i Claude-appene, i Claude Code og i API-et (modell-ID claude-fable-5-2), og hos Amazon Web Services, Google Cloud og Microsoft Azure.
| Modell | Rolle i familien | Pris inn / ut per million tokens |
|---|---|---|
| Claude Haiku 5.5 | Rask og billig, enkle oppgaver i stort volum | 0,10 / 0,50 dollar (under 100 000 tokens inn) |
| Claude Sonnet 5.5 | Hverdagsmodell for koding, agenter og kontorarbeid | 2 / 10 dollar |
| Claude Opus 5.5 | Anthropics anbefalte førstevalg til daglig arbeid | 4 / 20 dollar |
| Claude Fable 5.2 | Toppmodell for de mest krevende og åpne oppgavene | 8 / 40 dollar |
| Claude Mythos 5.2 | Samme evner som Fable, bare for godkjente organisasjoner | 8 / 40 dollar |
Prisene er Anthropics listepriser for API-et, fra prissiden. Tokens er ordbitene en modell leser og skriver, og 1 million tokens tilsvarer flere tusen sider tekst. Alle de fem modellene kan lese 1 million tokens i én forespørsel, og Fable 5.2 kan skrive opptil 128 000 tokens i ett svar. Rollebeskrivelsene er min oppsummering av Anthropics anbefalinger.
Hva er nytt fra Fable 5.1?
Ifølge Anthropic er versjon 5.2 bedre enn Fable 5.1 på koding, resonnering og bildeforståelse, og tre endringer betyr mest for en bedrift:
- 20 prosent lavere pris: 8 dollar inn og 40 dollar ut per million tokens, ned fra 10 og 50.
- Opptil 30 prosent raskere: svarene genereres raskere enn med Fable 5.1. En egen hurtigmodus gir opptil 2,5 ganger så rask tekst, til dobbel pris.
- Om lag 55 prosent færre blokkeringer samlet: i Anthropics tidlige testing stoppet sikkerhetssperrene langt færre forespørsler enn hos Fable 5.1. Innen cybersikkerhet var det 60 prosent færre, og innen biologi 40 prosent færre.
Benchmarks: hvor god er Claude Fable 5.2?
Tallene under er Anthropics egne, fra lanseringssiden, med høyeste innstilling for tenkedybde der ikke annet står. Hvert tall er en prosentandel, og høyere er bedre. Fable 5.2 leder på fem av seks tester; Gemini 4 Carbon leder på AutomationBench. På FrontierCode kjørte Fable 5.2 og 5.1 på nest høyeste tenkenivå (xhigh) og Gemini 4 Carbon på medium, og på Remote Labor Index kjørte Fable 5.2 på high. Fordi det er produsentens egne målinger, er de uavhengige målingene i neste avsnitt viktigere å feste seg ved.
| Test (Anthropics tall) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (koding) | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 (programvarearbeid) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (automatisering) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| OSWorld 2.1 (bruk av datamaskin) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| Humanity's Last Exam, med verktøy | 74,2 % | 65,6 % | 67,7 % | 57,2 % | ikke oppgitt |
| Remote Labor Index (ekte frilansoppdrag) | 41,3 % | 17,9 % | 21,3 % | 20,8 % | ikke oppgitt |
Hele benchmarktabellen slik Anthropic selv publiserte den, med alle 14 testene:
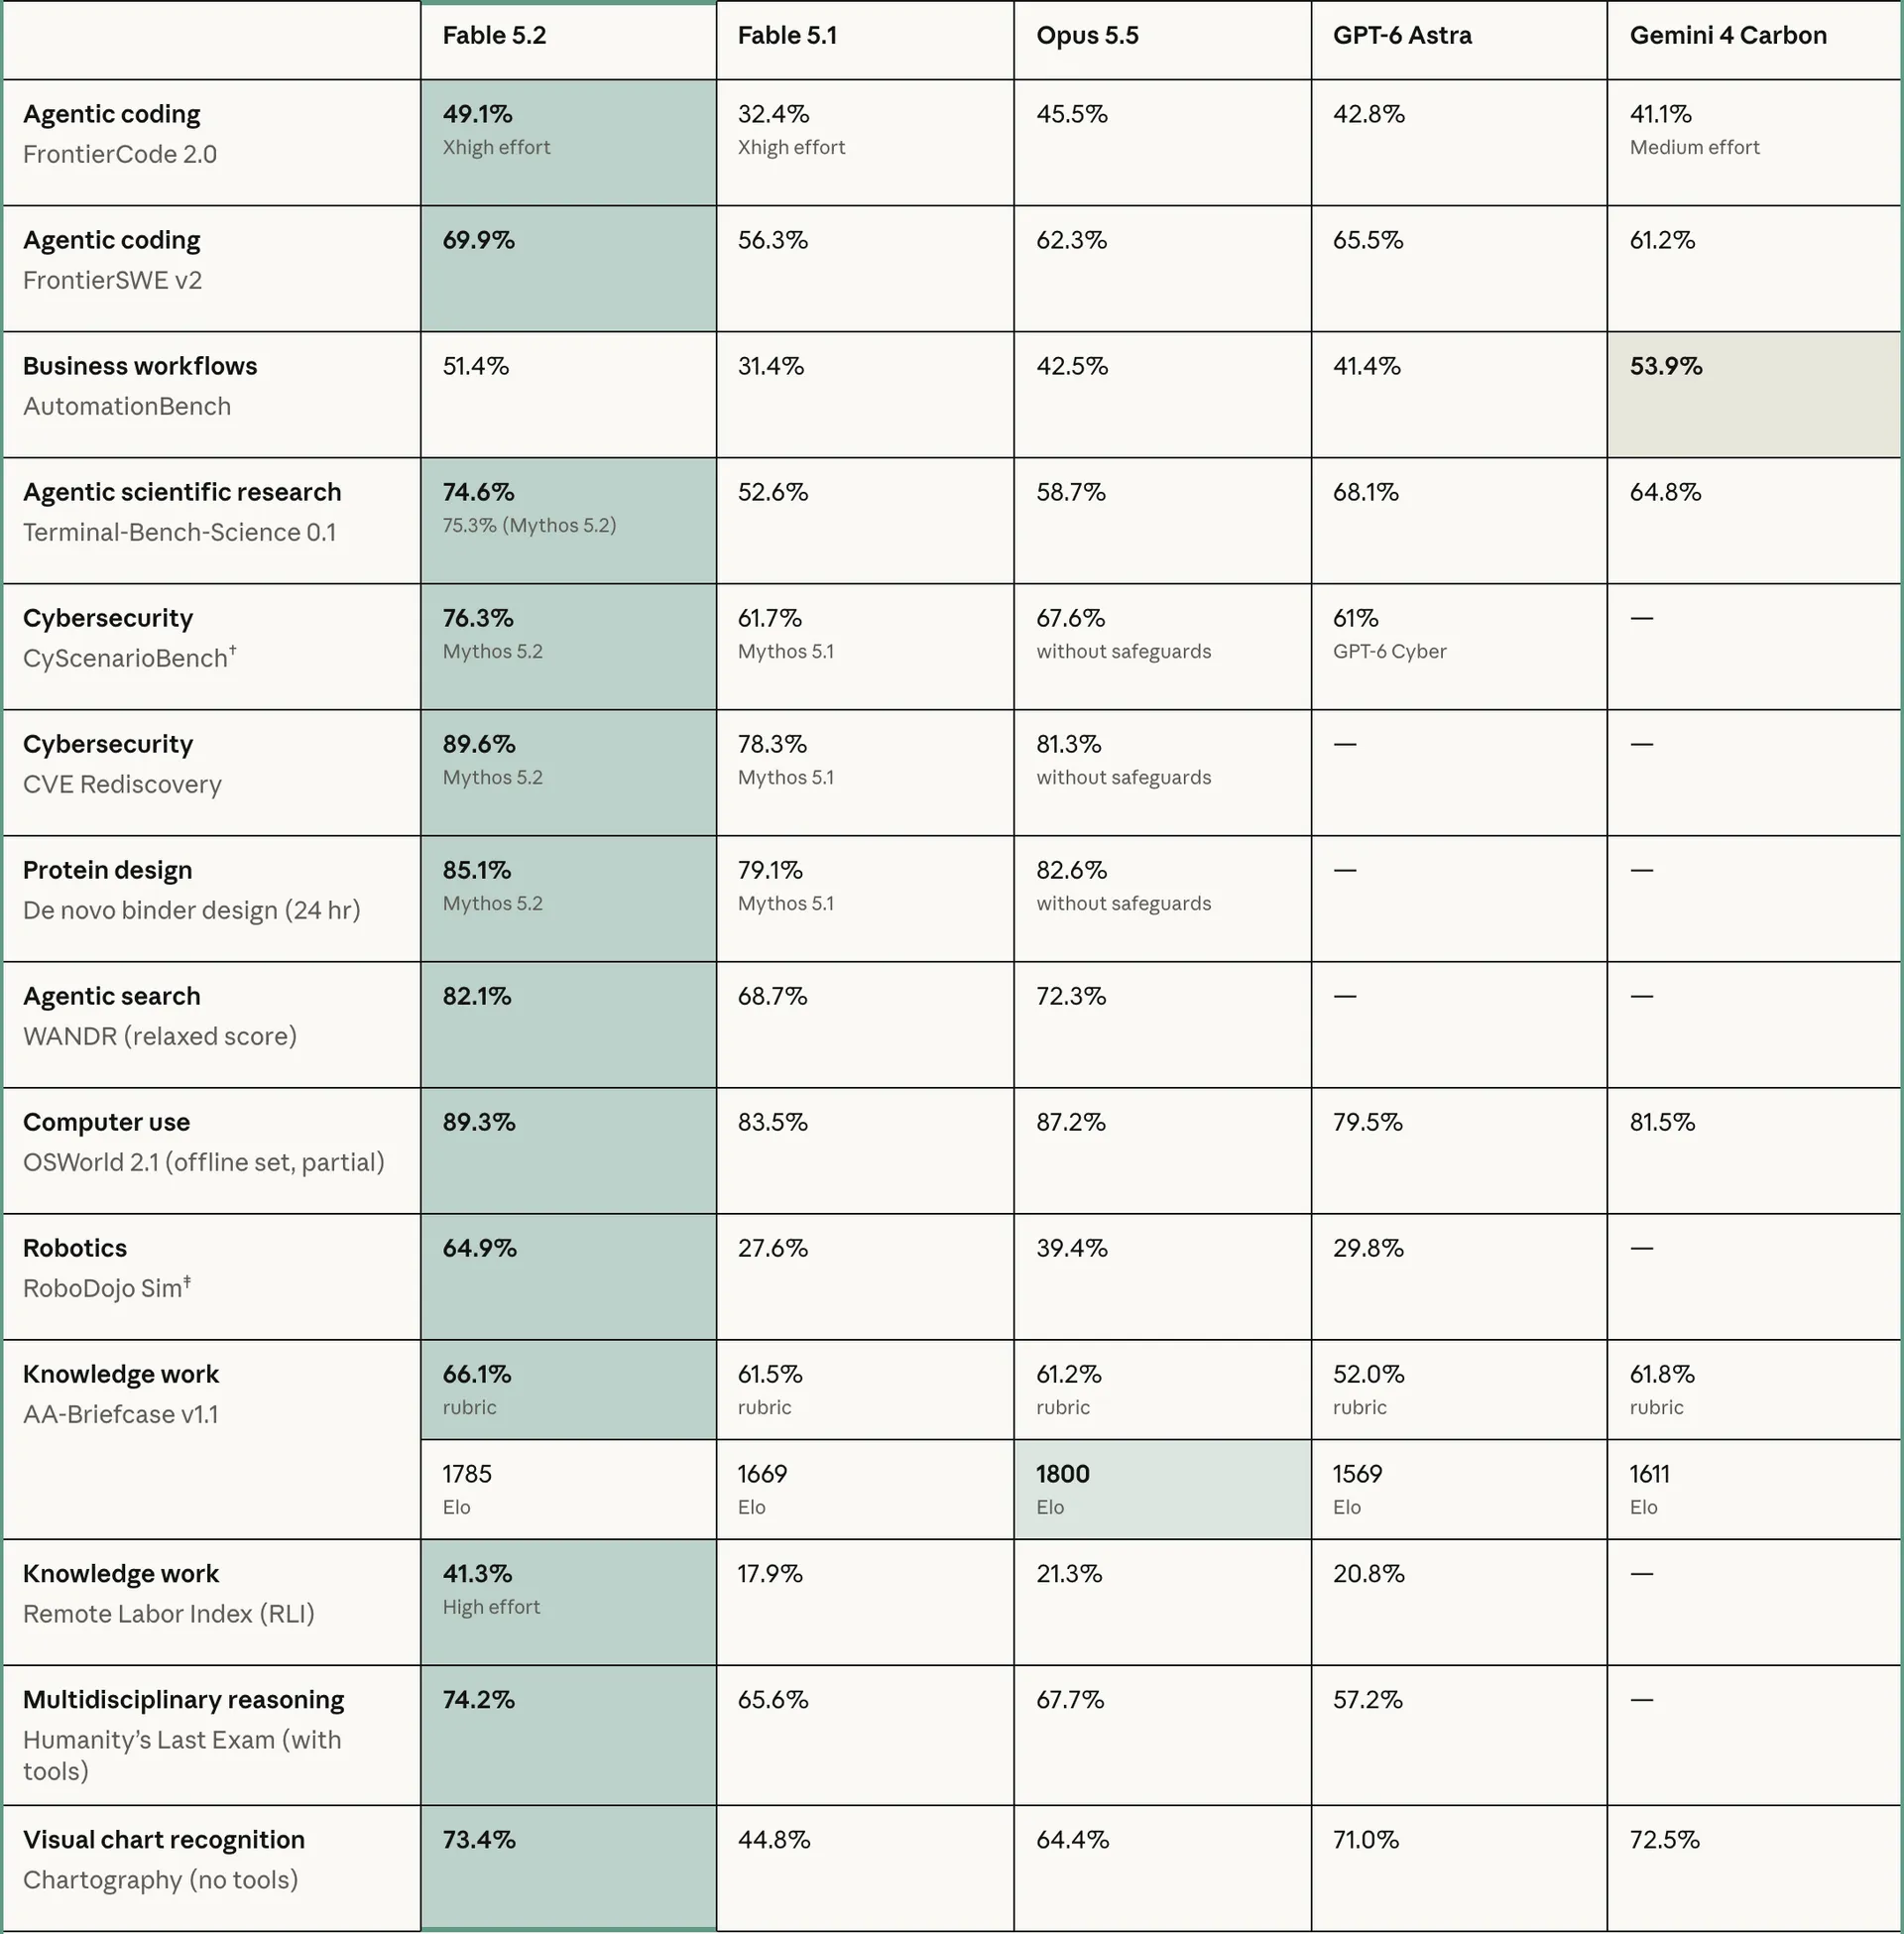
Kilde: Anthropic, lanseringssiden for Claude Fable og Mythos 5.2. Skjermbilde tatt 9. november 2026. Radene for cybersikkerhet og proteindesign i Fable-kolonnen er målt på Mythos 5.2, som bare godkjente organisasjoner får bruke.
Slik leser dere testene i tabellen over:
- FrontierCode 2.0 måler om kodeendringene modellen lager, ville blitt godtatt av dem som vedlikeholder åpne kodeprosjekter.
- FrontierSWE v2 gir modellen 34 svært lange programmeringsoppdrag, for eksempel å bygge en kretssimulator fra bunnen av. Hver oppgave gir 0 til 100 prosent.
- AutomationBench er laget av Zapier. Modellen får én beskjed om en forretningsflyt i salg, økonomi eller HR og må utføre den i simulerte fagsystemer, etter bedriftens regler. Bare riktig sluttresultat teller.
- OSWorld 2.1 måler hvor godt modellen bruker en vanlig datamaskin med skjermbilder, mus og tastatur over lange oppgaver.
- Humanity's Last Exam er 2 500 spørsmål skrevet av fageksperter, så vanskelige at de beste modellene sto fast da de ble samlet inn. Fable 5.2 fikk 74,2 prosent med verktøy, altså med tilgang til hjelpemidler som søk underveis.
- Remote Labor Index bruker ekte, betalte frilansoppdrag. Poengsummen er andelen oppdrag der leveransen holder et nivå som ville blitt akseptert som bestilt arbeid.
Det største forspranget på Opus 5.5 er på Remote Labor Index. Fable 5.2 dobler nesten Opus 5.5 (41,3 mot 21,3) og mer enn dobler Fable 5.1 (17,9). Likevel holdt under halvparten av leveransene mål.
Noen tester går til andre. Googles Gemini 4 Carbon leder på AutomationBench, og kontortesten AA-Briefcase gir et blandet bilde: Fable 5.2 leder på andelen oppfylte sjekkpunkter (66,1 mot 61,2 prosent), mens Opus 5.5 ligger litt foran på Elo, en rangering der leveranser sammenlignes parvis (1 800 mot 1 785). Vil dere sammenligne Claude og ChatGPT som verktøy i hverdagen, står det i ChatGPT vs Claude.
Hva uavhengige målinger sier
To uavhengige målere hadde tall klare samme dag:
- Artificial Analysis setter Fable 5.2 på førsteplass i Intelligence Index v5, en samlescore på tvers av mange tester, med 65 poeng, fem foran Gemini 4 Carbon, seks foran Opus 5.5 og 15 foran Fable 5.1. Samme måling viser at Fable 5.2 er svakere på agentisk kontorarbeid (oppgaver der modellen selv bruker verktøy over mange steg) og terminalbasert koding, der flere konkurrenter scorer høyere.
- Vals AI setter Fable 5.2 øverst av 36 modeller med 71,31 prosent, bare 0,46 poeng foran Claude Sonnet 5.5. Vals fant svake resultater på juridisk research og skatteoppgaver.
Målingene skiller seg i hvor stort forspranget er. Hos Vals AI ligger Sonnet 5.5 bare 0,46 poeng bak. Hos Artificial Analysis ligger Fable 5.2 seks poeng foran Opus 5.5 samlet, men bak på agentisk kontorarbeid. Min vurdering: til vanlig kontorarbeid er prisforskjellen vanskelig å forsvare.
Hva har folk bygget med Claude Fable 5.2?
Tallene sier mest når de knyttes til ekte arbeid. Disse eksemplene er publisert av Anthropic, kundene deres og uavhengige testere rundt lanseringen. Eksemplene er håndplukket av dem som publiserte dem, og jeg har ikke funnet uavhengig etterprøving av dem.
Fra arbeidsdagen i bedrifter:
| Hvem | Hva Fable 5.2 gjorde |
|---|---|
| Box | Gikk gjennom vedleggene til en lånesøknad og oppdaget at lønnsinnbetalingene ikke stemte med saldoen på kontoutskriften, så saksbehandleren visste hva som måtte sjekkes |
| Oracle | Skrev SQL for en rapport om gjeld per land som ga riktig svar. To andre modeller skrev SQL som kjørte, men summerte feil og ga tall fem til åtte ganger for høye |
| Fundamental Research Labs | Flyttet regnskapstall fra en årsrapport inn i en prognosemodell, la merke til at regionstallene ikke summerte til totalen, og fikk hver celle riktig |
| Harvey | Gjennomgikk dokumentasjonen på at ansatte har rett til å jobbe i USA, og pekte ut hvem som trengte oppfølging straks, hva som måtte rettes og hvem som skulle gjøre det |
| Uber | Kjørte en sikkerhetsrevisjon på 10 til 12 timer med rundt 170 agenter som gikk gjennom koden, og leverte rapport, ferdige rettinger og forslag til nye retningslinjer |
De mer spektakulære prosjektene:
| Hvem | Hva Fable 5.2 bygget |
|---|---|
| En ingeniør hos Anthropic | Et fungerende operativsystem fra en tom mappe, med over 1 000 underagenter i åtte døgn. Det starter på en vanlig bærbar PC og har innlogging, vinduer, filsystem og installasjonsprogram |
| Anthropic og Diode | Tre elektroniske dingser fra korte beskrivelser: en høyttalertelefon, en stemmeassistent og et digitalt kjæledyr. Modellen valgte komponenter, tegnet kretskortene og skrev programvaren, og alle tre virket uten endringer i kretsene |
| Ethan Mollick, professor i entreprenørskap | Gjorde et lite USB-tastatur med lysende taster om til en spillkonsoll med seks spill, uten noen bruksanvisning å gå etter |
| Claire Vo i Lenny's Newsletter | Laget en animert reklamefilm fra én post på X og en merkevarehåndbok, og monteringsanvisning for flatpakkede møbler ut fra uskarpe bilder av delene |
| Discovered Materials | Gjorde en tung beregning i materialforskning i snitt 36 ganger raskere på samme grafikkprosessor (GPU), fra 3,3 timer til under fire minutter |
Felles for eksemplene i den første tabellen er at modellen fant feil og avvik et menneske lett kunne oversett. Det er der Fable 5.2 har mest å gi en vanlig bedrift. Operativsystemet brukte over 1 000 underagenter i åtte døgn, et oppsett få bedrifter har.
Claude Fable 5.2 eller Opus 5.5: hva er forskjellen?
Fable 5.2 koster dobbelt så mye per token som Opus 5.5 og løser flere av de vanskeligste oppgavene. På vanlig kontorarbeid er forskjellen liten, og Anthropic anbefaler Opus 5.5 som førstevalg.
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| Pris inn / ut per million tokens | 8 / 40 dollar | 4 / 20 dollar |
| FrontierCode 2.0, koding (Anthropic) | 49,1 % | 45,5 % |
| Remote Labor Index, frilansoppdrag (Anthropic) | 41,3 % | 21,3 % |
| Intelligence Index v5 (Artificial Analysis) | 65 poeng | 59 poeng |
| Kostnad per oppgave, høyeste innstilling (Artificial Analysis) | 26,50 dollar | 10 dollar |
| Anthropics anbefaling | Store, åpne tekniske oppgaver | Førstevalg til daglig arbeid |
Hva koster Claude Fable 5.2?
Prisen per token er dobbelt så høy som for Opus 5.5. I praksis avhenger regningen mest av hvor lenge modellen tenker per oppgave. Artificial Analysis målte gjennomsnittlig kostnad per oppgave med høyeste innstilling (referert av The Decoder). Selv med 20 prosent lavere tokenpris koster Fable 5.2 der om lag dobbelt så mye per oppgave som Fable 5.1, fordi den bruker flere tokens på å tenke:
Tenkedybden (effort) avgjør hvor lenge modellen tenker før den svarer, og er derfor den viktigste innstillingen for kostnaden. Den går fra low til max, og ifølge Anthropic er medium standard i Claude-appene og Claude Code. I API-et er standard high for Fable 5.2 og medium for Opus 5.5, så sett tenkenivået likt når dere sammenligner kostnad. To funn er verdt å kjenne:
- High ga samme kodingsresultat som Opus 5.5. I Anthropics kodingstest FrontierCode nådde Fable 5.2 på high samme resultat som Opus 5.5 på sitt beste (45,3 mot 45,5 prosent), ifølge Anthropic til omtrent halv kostnad per oppgave. Det gjelder high; diagrammet over viser høyeste innstilling i en annen måling.
- Max lønte seg dårlig hos Vals AI. High ga best totalresultat til 17,94 dollar per test. Max kostet 49,62 dollar, 2,77 ganger så mye, og falt til omtrent sjuendeplass, fordi lange tankerekker brukte opp budsjettet før svaret var ferdig.
Hvordan jeg målte og kuttet mitt eget forbruk, står i kuttet AI-forbruket med 31 prosent.
Slik har jeg satt opp Fable 5.2 som rådgiver i Claude Code
Jeg bruker Claude Code hver dag til å bygge og drifte systemene våre, og det meste av arbeidet gjør Sonnet 5.5 og Opus 5.5. Samme dag Fable 5.2 kom ut, satte jeg den opp som rådgiver i stedet for Opus 5.5, som har hatt jobben til nå. De siste to ukene ga Opus 5.5 råd rundt 2 200 ganger i øktene mine. Oppsettet er fra lanseringsdagen, så jeg har ingen resultater å vise ennå.
Hva er en rådgiver (advisor)?
En rådgiver er en sterkere modell som den vanlige modellen spør til råds underveis. Rådgiveren ser hele samtalen så langt og svarer med en anbefaling, og så fortsetter hovedmodellen arbeidet. Anthropic beskriver to bruksmønstre for Fable 5.2: som rådgiver, der Haiku, Sonnet eller Opus spør Fable om hjelp med vanskelige problemer, og som dirigent, der Fable fordeler enklere deloppgaver til mindre modeller.
Oppsettet mitt
- Hovedmodellen gjør jobben. Sonnet 5.5 eller Opus 5.5 leser filer, skriver kode og kjører tester.
- Fable spørres på vendepunktene: før en plan låses, når noe har stått fast en stund, og før en oppgave meldes som ferdig.
- Fast tak på antall kall. I den daglige SEO-agenten vår kan rådgiveren brukes høyst to ganger per kjøring.
Taket finnes fordi et rådgiverkall blir dyrt når samtalen er lang. I min første test leste Fable rundt 75 000 tokens med samtalehistorikk, uten mellomlagring, og ett kall kostet omtrent 0,62 dollar. To kall per kjøring blir da rundt 1,25 dollar. Med Fable som hovedmodell betales Fable-pris for hvert steg i økten. Et regneeksempel: ti steg som hver leser 75 000 tokens koster rundt 6 dollar i input uten mellomlagring. Med mellomlagring koster gjenlest tekst 0,20 dollar per million tokens, så taket på to kall er en forsiktig sikring mer enn en regning de fleste vil få.
Hva testene betyr for min egen bruk
Jeg telte hva Claude Code faktisk gjorde hos meg de siste 14 dagene: 1 199 økter og rundt 328 000 verktøykall fra meg og agentene mine. Opus 5.5 skrev 74 prosent av svarene og Sonnet 5.5 25 prosent. Slik fordeler arbeidet seg på testene som ligner mest:
| Det Claude Code gjorde hos meg | Andel av verktøykallene | Nærmeste test | Fable 5.2 foran Opus 5.5 |
|---|---|---|---|
| Lese, skrive og teste kode, git og annet terminalarbeid | 87 % | FrontierCode 2.0 og FrontierSWE v2 | 3,6 og 7,6 prosentpoeng |
| Fordele arbeid til andre agenter og følge med på dem | 5 % | Ingen egen test | Ikke målt |
| Arbeid i fagsystemer: oppgavestyring, analyse, CRM og publisering | 3 % | AutomationBench | 8,9 prosentpoeng |
| Nettleser og skjerm | 0,5 % | OSWorld 2.1 | 2,1 prosentpoeng |
| Søk på nett | 0,3 % | WANDR | 9,8 prosentpoeng |
Nesten alt er koding og terminalarbeid, der Fable 5.2 ligger 4 til 8 prosentpoeng foran Opus 5.5 i Anthropics egne tester. Fordi Fable er rådgiver og ikke gjør selve arbeidet, venter jeg ikke at prosentene slår rett inn. Det jeg venter, er færre feilspor: at planen er riktig første gang, og at færre oppgaver må gjennom en ny runde med kodegjennomgang.
Bør bedriften deres bruke Claude Fable 5.2?
For de fleste norske bedrifter er svaret: til noen få, krevende oppgaver.
| Oppgave | Modell som holder |
|---|---|
| E-post, oppsummering, kundeservice-utkast | Sonnet 5.5 eller Haiku 5.5 |
| Daglig koding, analyse, rapporter | Opus 5.5 |
| Store, åpne tekniske oppgaver over mange timer | Fable 5.2 |
| Kvalitetssikring av viktige valg i en AI-agent | Fable 5.2 som rådgiver (Anthropics bruksmønster, ennå ikke målt hos oss) |
Sjekk to ting før dere tar Fable 5.2 i bruk via API:
- Datalagring. Ifølge Anthropics dokumentasjon om datalagring krever Fable 5.2 at data lagres i 30 dager, og modellen er ikke tilgjengelig under avtale om null datalagring (zero data retention) uten særskilt godkjenning fra Anthropic. En organisasjon med slik avtale kan slå på 30 dagers lagring for ett enkelt arbeidsområde. Bruker dere Claude via Amazon Bedrock eller Google Cloud, blir de lagrede dataene hos skyleverandøren. Behandler dere personopplysninger eller taushetsbelagte data, må dette avklares mot databehandleravtalen deres først.
- Kostnad per ferdig oppgave. Mål kostnaden per ferdig oppgave. En dyr modell som løser oppgaven på første forsøk kan bli billigere enn en billig modell som trenger fem.
Vil dere finne ut hvilke oppgaver i bedriften som er verdt en toppmodell, og hvilke som går fint på en billigere, kan en AI-konsulent gå gjennom arbeidsflyten med dere. Vi bygger også løsningene, se AI-utvikling, og lærer de ansatte å velge riktig modell på AI-kurs.
Kilder
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2, 9. november 2026 (priser, benchmarks, hastighet, avvisninger, bruksmønstre, kundeeksempler og operativsystemet)
- Anthropic: API and data retention (krav om 30 dagers datalagring)
- The Decoder: Claude Fable 5.2 and Mythos 5.2 cement Anthropic's AI lead (tall fra Artificial Analysis)
- AlphaSignal: Claude Fable 5.2 tops 36 models but max reasoning backfires (tall fra Vals AI)
- Anthropic: prisside og modelloversikt (priser, mellomlagring, standard tenkenivå)
- Ethan Mollick: Fable 5.2 and Jagged AGI, One Useful Thing (tastaturet som ble spillkonsoll)
- Lenny's Newsletter: Claude Fable 5.2 review: fast, creative, and finally not annoying (Claire Vo: reklamefilm og møbelmontering)