Qwen er Alibabas familie av AI-modeller, og Qwen4-Max er den nyeste og største modellen i den, lansert 16. november 2026. Den koster 1,50 dollar per million tokens inn og 4,50 dollar ut via API. Den er sterk på agentisk koding og juridisk agentarbeid, ligger bak Claude Opus 5.5 på de fleste kontoroppgavene i Alibabas oversikt, og gir mest for en norsk bedrift der kostnad per oppgave betyr mer enn toppresultat.
Under står hva modellen er, hva testene viser, hva den koster, og hva bedriften må avklare om data og personvern før den tas i bruk.
Hva er Qwen4-Max?
Qwen4-Max er den største modellen i Qwen4-serien fra Alibaba, utviklet av Qwen-teamet. Alibaba kaller den en AI-kollega for arbeid, kreativt arbeid og forskning, og den er laget for lange oppgaver der modellen selv bruker verktøy over mange steg.
| Egenskap | Qwen4-Max |
|---|---|
| Lansert | 16. november 2026 |
| Utvikler | Alibaba (Qwen-teamet) |
| Modell-ID i API-et | qwen4-max |
| Størrelse | 2,4 billioner parametere totalt, 71 milliarder aktive per token |
| Kontekstvindu | 1 million tokens |
| Leser | Tekst, bilder og video |
| Skriver | Tekst |
| Tenkenivå | low, high og xhigh (high er standard) |
| Kompatibilitet | OpenAI- og Anthropic-API-ene, verktøykall, nettsøk og strukturerte svar |
| Åpne vekter | Nei. Mindre Qwen4-modeller med åpne vekter kommer ifølge Alibaba senere |
Tokens er ordbitene en modell leser og skriver. 1 million tokens tilsvarer rundt 1 500 A4-sider tekst. Artificial Analysis anslår 1 475 sider for 984 000 tokens. At modellen har 2,4 billioner parametere men bare bruker 71 milliarder per token, betyr at den er bygget som en Mixture-of-Experts-modell: bare en liten del av modellen regner på hvert ord, og ifølge Alibaba gir det lavere kostnad når modellen brukes.
Modellen finnes i QwenCloud via API og abonnementet Token Plan, og i Alibabas egne verktøy QwenWork og QwenStudio.
Hva er nytt fra Qwen3.8-Max?
Ifølge Alibaba gjør Qwen4-Max det bedre enn forgjengeren på nesten alle testene de har kjørt, og bruker færre tokens på det:
- Ny arkitektur. 25 prosent færre aktive parametere per token enn Qwen3.8-Max, med samme totale størrelse.
- Færre tokens per oppgave. På Alibabas egen test Work360 bruker modellen om lag 35 prosent færre tokens på tenkenivå high, og 24 prosent færre på xhigh. På kodingstesten Terminal-Bench 4.0 er kuttet om lag 49 og 48 prosent.
- Lavere kostnad per oppgave. I Work360 falt gjennomsnittlig kostnad per oppgave fra 4,43 til 1,67 dollar, en nedgang på 62 prosent. Alibaba har også satt ned API-prisene, mest for mellomlagret input.
- Bedre resultat på arbeidsoppgaver. Work360 dekker 721 fagområder. Qwen4-Max fikk 52,69 poeng, mot 47,74 for Qwen3.8-Max.
Work360 er Alibabas egen test, så tallene er ikke etterprøvd av andre.
Benchmarks: hvor god er Qwen4-Max?
Alibaba sammenligner Qwen4-Max med forgjengeren, Claude Opus 5.5 fra Anthropic, GPT-6.1 Sol og GPT-6 Astra fra OpenAI og Kimi K3.1 fra Moonshot. Tallene under er fra Alibabas lanseringsside. Noen av dem er hentet fra uavhengige ledertavler, som Alibaba oppgir i fotnotene (AA-Briefcase og Automationbench-AA fra Artificial Analysis, APEX-Agents fra Mercor og HLAB-Vals fra Vals). Resten er Alibabas egne målinger.
| Test (Alibabas oversikt) | Hva den måler | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | Agentisk koding | 75,7 | 69,3 | 74,2 | 75,2 | 75,5 |
| Terminal-Bench 4.0 | Koding i terminalen | 48,5 | 38,9 | 59,6 | 56,1 | 67,2 |
| AA-Briefcase v1.1 (Elo) | Kunnskapsarbeid med dokumenter | 1 686 | 1 605 | 1 801 | 1 555 | 1 674 |
| JobBench | Ekte yrkesoppgaver | 68,5 | 65,3 | 75,4 | 66,2 | 61,2 |
| APEX-Agents v1.1 | Oppgaver fra rådgivning og profesjonelle tjenester | 72,1 | 63,3 | 73,5 | 60,0 | 65,5 |
| HLAB-Vals-1.1 | Juridisk agentarbeid | 21,3 | 15,4 | 9,2 | 6,3 | 11,7 |
| Automationbench-AA | Arbeidsflyter i SaaS-systemer | 72,5 | 56,2 | 69,5 | 64,9 | 73,3 |
| Humanity's Last Exam | Svært vanskelige fagspørsmål | 51,7 | 43,9 | 59,8 | 54,0 | 51,1 |
GPT-6 Astra er utelatt i tabellen, men står i figuren under. Høyere er bedre i alle radene. Elo er en rangering der leveranser sammenlignes parvis. Hva testene måler og hvordan de leses, står i AI-benchmarks forklart.
Bildet er tydelig: Qwen4-Max leder på agentisk koding (DeepSWE), juridisk agentarbeid (HLAB-Vals) og lange oppgaver (Agents' Last Exam i figuren), og ligger nær toppen på automatisering i fagsystemer. Claude Opus 5.5 ligger foran på dokumentarbeid, yrkesoppgaver, rådgivningsoppgaver (APEX-Agents) og de vanskeligste fagspørsmålene. På koding i terminalen ligger Qwen4-Max klart bak alle de tre konkurrentene.
Hele oversikten slik Alibaba publiserte den, med alle 16 testene:
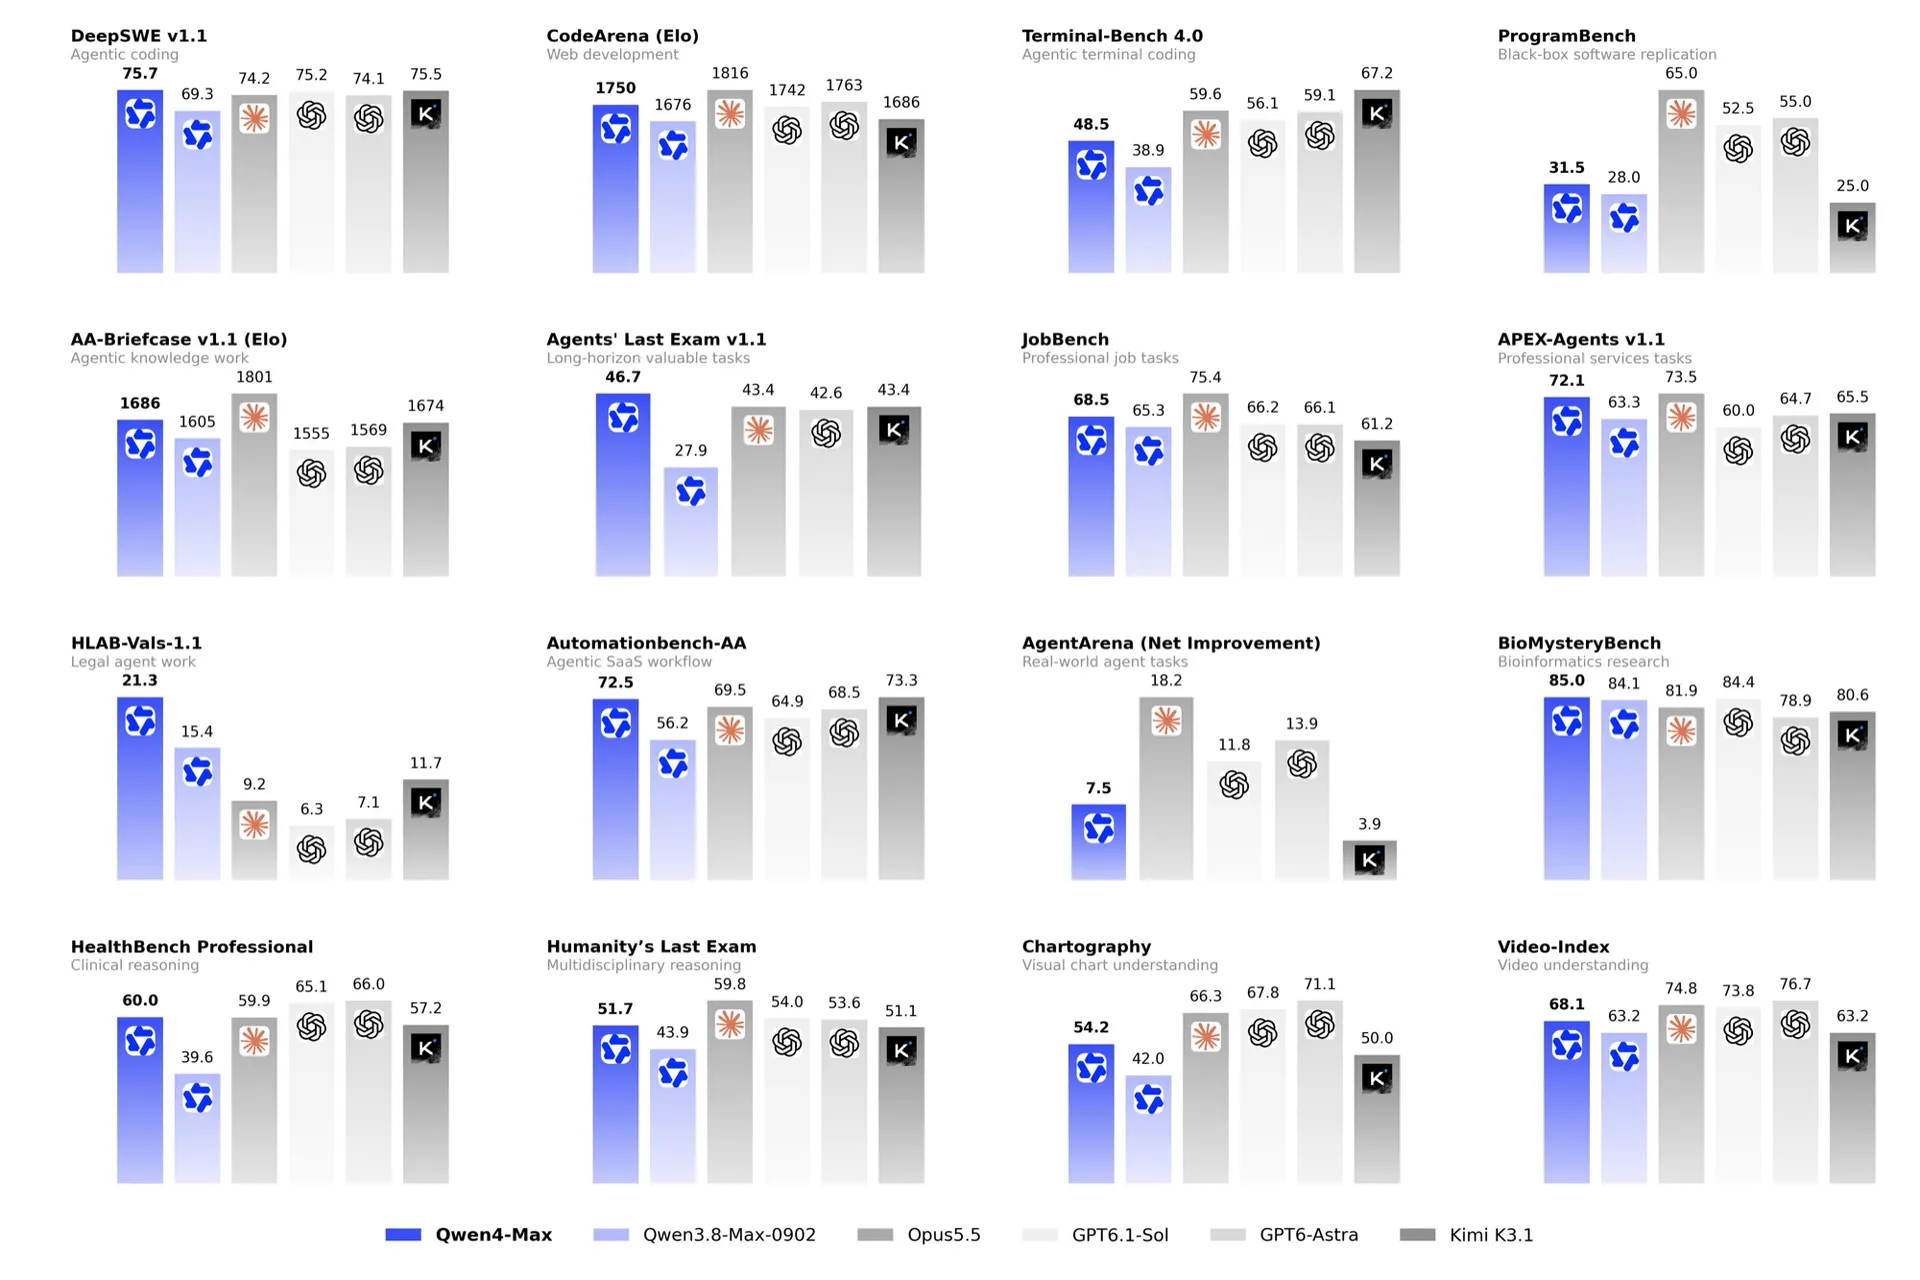
Kilde: Qwen-teamet, lanseringssiden for Qwen4-Max, 16. november 2026.
I pressemeldingen oppgir Alibaba også at Qwen4-Max er nummer 6 på Code Arena, en ledertavle der brukere stemmer over hvilken modell som løste en kodeoppgave best.
Hva uavhengige målinger sier
Artificial Analysis hadde tall klare på lanseringsdagen. Qwen4-Max får 43 poeng i Intelligence Index, en samlescore over ni tester innen agentisk koding, kontorautomatisering, kunnskap og fysikk. Det gir plass 38 av 81 modeller, litt over medianen på 41 for sammenlignbare modeller.
Den samme målingen viser to svakheter. Modellen er ordrik: den brukte 127 millioner tokens på testene, mot en median på 78,6 millioner. Den er også treg, med 32,1 minutter per oppgave mot en median på 13,3.
Hva har folk bygget med Qwen4-Max?
Eksemplene under er publisert av Alibaba selv på lanseringssiden, og vi har ikke funnet uavhengig etterprøving av dem.
| Hvem | Hva modellen gjorde ifølge Alibaba |
|---|---|
| SANF og Pacific Union (bilproduksjon) | Planla produksjonslinjer, tegnet bildeler og kontrollerte maskineringen. Manuell programmering av ett arbeidsstykke gikk fra rundt 475 til 24 minutter |
| Alibaba Cloud | Optimaliserte sin egen ressursstyring i skyen og kuttet kostnaden for modellkall til datamerking med 9 til 10 prosent i snitt (pressemeldingen sier 9, lanseringssiden 10,42) |
| Forskningsprosjekt om kjøling av databrikker | Kjørte i 48 timer i strekk gjennom fire runder med molekyldesign, syntese og testing, og fant et nytt kjølemiddel som ble testet i laboratoriet |
Felles for eksemplene er lange oppgaver der modellen jobber selv med verktøy over mange steg, i ett av eksemplene med 90 MCP-koblinger til finansdata. Hva MCP er, står i hva er MCP.
Qwen4-Max eller Claude Opus 5.5: hva er forskjellen?
Claude Opus 5.5 er den første konkurrenten i Alibabas oversikt, og den vi sammenligner med her.
| Qwen4-Max | Claude Opus 5.5 | |
|---|---|---|
| Pris inn / ut per million tokens | 1,50 / 4,50 dollar | 4 / 20 dollar |
| Intelligence Index (Artificial Analysis) | 43 poeng | 59 poeng |
| Kostnad per oppgave i indeksen (Artificial Analysis) | 3,27 dollar | 10,04 dollar |
| DeepSWE v1.1, agentisk koding (Alibaba) | 75,7 | 74,2 |
| JobBench, yrkesoppgaver (Alibaba) | 68,5 | 75,4 |
| Utvikler | Alibaba, Kina | Anthropic, USA |
Opus 5.5 gir bedre resultat på de fleste kontoroppgavene. Qwen4-Max koster om lag en tredjedel per oppgave. Hva Anthropics modeller koster og når toppmodellen deres lønner seg, står i Claude Fable 5.2.
Vurderer dere andre kinesiske modeller, er DeepSeek V4 og prisene det nærmeste alternativet vi har skrevet om.
Hva koster Qwen4-Max?
Prisene er Alibabas listepriser i Model Studio for regionen Singapore (International), lest 17. november 2026.
| Hva | Pris per million tokens |
|---|---|
| Input (opptil 1 million tokens per forespørsel) | 1,50 dollar |
| Output, med og uten tenking | 4,50 dollar |
| Input lest fra mellomlager (cache) | 0,075 dollar |
| Skriving til mellomlager, 5 minutter | 1,875 dollar |
| Skriving til mellomlager, 1 time | 3 dollar |
Samme pris gjelder for hele kontekstvinduet, så en lang forespørsel koster det samme per token som en kort. Nye brukere i Singapore-regionen får 1 million gratis tokens som gjelder i 90 dager.
Tokenprisen alene forteller lite, fordi modellen er ordrik. Mål kostnaden per ferdig oppgave på deres egne oppgaver før dere velger.
Bør bedriften deres bruke Qwen4-Max?
For de fleste norske bedrifter er svaret: test den på avgrensede oppgaver uten personopplysninger først.
| Oppgave | Passer Qwen4-Max? |
|---|---|
| Agentisk koding og automatisering i fagsystemer, i stort volum | Ja, verdt å teste. Lav pris per oppgave og gode resultater i Alibabas tester |
| Juridisk gjennomgang med agent | Verdt å teste. Leder HLAB-Vals, men med lave poeng for alle modellene |
| Dokumentarbeid, rapporter og kundeskriving | Opus 5.5 ga bedre resultat i de samme testene |
| Oppgaver med personopplysninger eller taushetsbelagte data | Først etter at databehandling og region er avklart (se under) |
Avklar tre ting før dere tar modellen i bruk via API:
- Region og hvor inferensen kjøres. I Model Studio bestemmer regionen hvor data lagres, og et eget valg, deployment scope, bestemmer hvor modellen regner. Frankfurt-regionen støtter både omfanget Global og EU. Modellsiden vi leste 17. november, oppga omfanget Global for Qwen4-Max. Alibaba beskriver bare de regionbundne omfangene som geografisk avgrenset, så med Global kan modellen regne utenfor EU. Sjekk om EU-omfanget er tilgjengelig for modellen i Alibabas dokumentasjon om regioner før dere sender personopplysninger.
- Databehandleravtale. Alibaba er et kinesisk selskap. Avklar i avtalen hvor data lagres og behandles, og om noe overføres ut av EØS. Hva GDPR krever når dere tar i bruk AI, står i AI og GDPR i Norge.
- Kostnad per ferdig oppgave. Kjør de samme oppgavene på Qwen4-Max og modellen dere bruker i dag, og sammenlign kostnad og kvalitet per ferdig oppgave.
Vil dere finne ut hvilke oppgaver i bedriften som passer for en billig modell, og hvilke som trenger en dyrere, kan en AI-konsulent gå gjennom arbeidsflyten med dere. Vi bygger også løsningene, se AI-utvikling, og lærer de ansatte å velge riktig modell på AI-kurs.
Kilder
- Qwen-teamet: Qwen4-Max: Your New Teammate Has Arrived, 16. november 2026 (arkitektur, Work360, tokenbruk, kostnad per oppgave, benchmarkoversikt, eksempler)
- Alibaba Cloud: Alibaba Unveils Qwen4-Max, pressemelding 16. november 2026 (parametere, Code Arena, åpne vekter)
- Alibaba Cloud Model Studio: qwen4-max, prisliste og regioner og deployment scope, lest 17. november 2026
- Artificial Analysis: Qwen4 Max, lest 17. november 2026 (Intelligence Index, kostnad og tid per oppgave, tokenbruk)
- Anthropic: prisside, lest 17. november 2026 (pris for Claude Opus 5.5)